
💡 Agent 做不好,不一定是模型做不好。先看模型拿到了什麼、能做什麼,再沿著 Agent Loop 找真正的瓶頸。
昨天在 Day 1|Production Agent Harness 要管什麼:三十天拆開模型外面的控制系統,我們從一次 LLM Request 一路加上 Tool Call,最後得到最基本的 Agent Loop:模型提出下一步,Harness 執行工具,再 把結果送回模型。並且定調了我們理解的 Harness 能決定模型看得到什麼、被允許做什麼、做完之後怎麼確認,讓結果不一定可靠的 LLM,也能一步步穩定地完成目標。
那把需要的工具都接好,剩下的事情是不是交給一個夠聰明的模型就好了?
有些任務確實可以。但 Agent 做不好時,光看最後的回答,還不容易分辨是模型沒把事情做好,還是外面的系統讓它很難做好。今天就用兩個行事曆情境,看看什麼時候值得換模型,什麼時候要先改 Harness。
假設我做了一個行事曆 Agent,使用者問:
幫我查未來四週,工作和專案兩個行事曆裡,週二或週四下午開始、有 Amber 參加,而且至少 45 分鐘的會議,按時間列出最早三場。
先假設兩個行事曆都能讀到完整明細,Amber 已對應到 email,下午也約定為台北時間 13:00–18:00。
我們先提供一個基本的 list_events 工具:一次查一個行事曆,可以指定時間範圍、加上文字搜尋,資料太多時就分頁回傳。
為了讓例子具體一點,假設這次從 2026 年 9 月 21 日開始查四週,到 10 月 19 日為止。模型可以先提出查詢工作行事曆的要求,由 Harness 檢查後執行。下面用 pseudocode 示意一次工具呼叫,不是 Google API 的真實介面:
page = list_events(
    calendar_id="work",                   # 工作行事曆的示意 ID
    start="2026-09-21T00:00:00+08:00",     # 查詢區間起點
    end="2026-10-19T00:00:00+08:00",       # 查詢區間終點
    query="Amber@example.com",            # 文字搜尋,不限參與者欄位
    page_token=None,                      # 第一次查詢,不帶分頁 token
)
回傳結果可能長這樣。這裡只保留說明需要的欄位,資料也是假設的:
{
    "events": [
        {
            "id": "event_001",
            "title": "專案同步",
            "start": "2026-09-22T14:00:00+08:00",
            "end": "2026-09-22T15:00:00+08:00",
            "attendees": ["Amber@example.com"],
        }
    ],
    "next_page_token": "next-page-token",
}
開始與結束時間可以用來判斷星期、時段和會議長度,參與者名單則可以確認 Amber 是否在裡面。但這只是工作行事曆的一頁查詢結果,還不是符合全部條件的前三場會議。
如果還需要下一頁,就沿用相同的查詢條件,把回傳的 next_page_token 帶進下一次呼叫的 page_token。這個示意工具約定,沒有下一頁時回傳 None;Google Calendar 原生 API 則使用 nextPageToken,沒有下一頁時省略該欄位。
這個工具並不是做不到。模型接下來還要查專案行事曆,取得需要的分頁,再檢查星期、開始時間、參與者和會議長度,最後合併排序。同一場會議若在兩邊都有,還要避免重複計算。
它也可以先算出有哪些週二、週四下午,只查那些時段。前一種可能拿回比較多無關資料,後一種則要安排更多查詢。使用者只問了一句話,模型卻要先決定怎麼查,再一路記住所有條件。
Google Calendar 可以指定時間範圍、搜尋關鍵字,也能一頁一頁查資料,但不能直接把「週二或週四下午、有 Amber 參加、至少 45 分鐘」這些條件一次交給它處理。另外,搜尋 Amber 時,可能只是某場會議的標題或說明提到她,不代表她就在參與者名單裡,所以查回來之後,還要再確認一次。
小提醒:如果示意工具沿用 Google Calendar 的時間篩選方式,查回的是與區間重疊的事件。例如查 13:00–18:00,也可能拿到 12:30 開始、13:30 結束的會議,所以「下午開始」仍要核對事件的開始時間。
如果最後漏掉「至少 45 分鐘」,換一個更會規劃、使用工具的模型,確實有可能改善。但我也會回頭問:這些篩選、分頁和排序,有必要每次都讓模型重新安排嗎?
如果這是經常出現的需求,可以讓工具接受 weekday、time_slot、參與者和會議長度等條件,再由程式處理查詢、去重與排序。工具背後仍可能呼叫多次 API,只是不必把每個固定步驟都交給模型安排。工具的用途、參數和回傳結果怎麼約定,就是這裡說的 Tool Contract。
查詢步驟之外,還有一個分工值得注意:計算結果由誰負責?
早期使用模型時,我遇過把只有三個元素的 array 傳給它,問有幾個,它卻回答兩個。明明一行 len(items) 就能解決,繞了一圈交給模型,連從三數到二這種事都能發生。
這也讓人想到「strawberry 到底有幾個 r」的老梗。2024 年有位使用者貼過下面這張對話截圖:模型先回答兩個 r,補上一句「Verify with code」後,又改成三個。
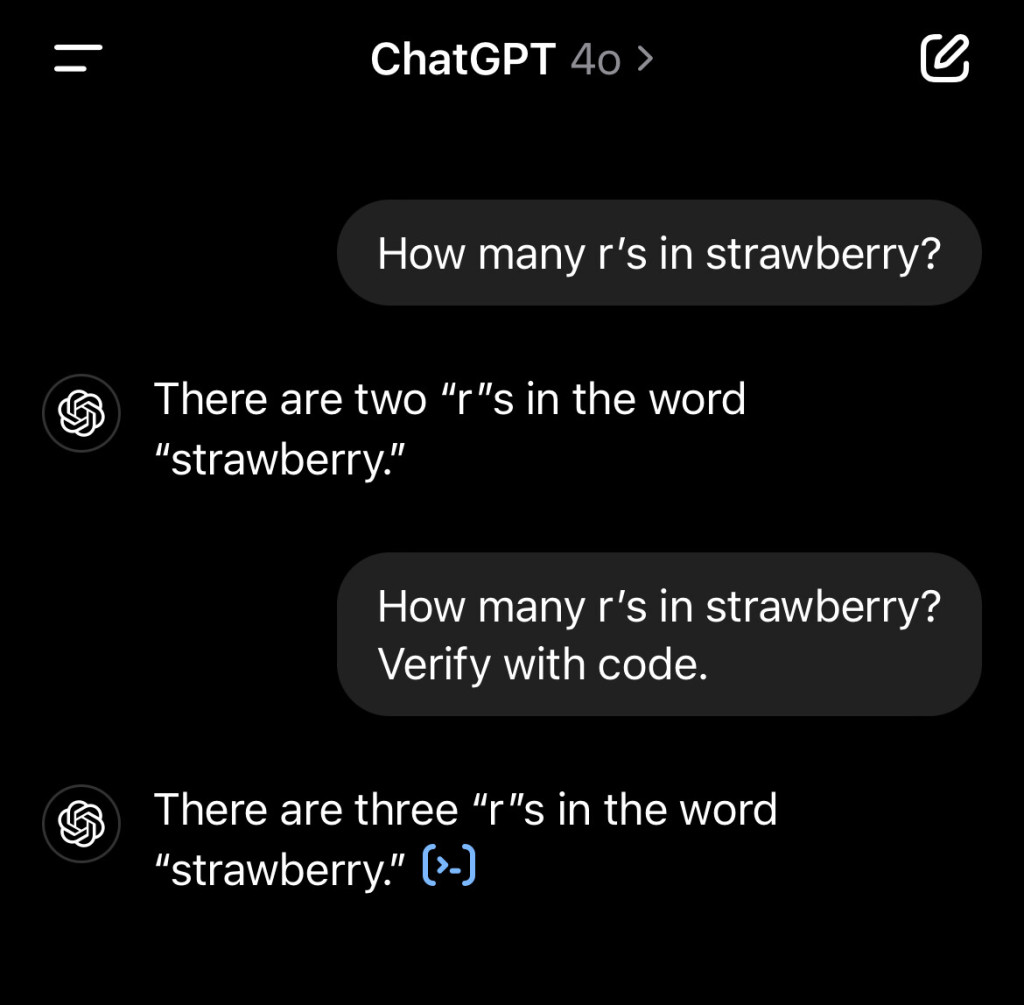
圖:來自 w_c_online 的社群貼文(2024/6/19)。這是歷史個案,截圖未展示完整執行紀錄,不是現行模型評測,也不是前面的 array 案例。
這不是說模型完全不會計算,Anthropic 的研究也觀察到模型學到了加法策略。真正要分清楚的是:模型能算對,不代表每個數字都該交給它算。 設計 Agent 時,規則明確的計算應優先交給 Harness 呼叫的工具,模型則負責理解需求、選擇操作與說明結果。即使新模型能把這類小題做好,也不必把原本一行程式能處理的計數交給它。
回到 Calendar,工具可以先算好會議長度、完成篩選,再把清單和筆數一起回傳,而不是讓模型從文字裡重新數一次。下面是說明用的 pseudocode:
# selected_events 是這次實際回傳的會議清單
result = {
    "events": selected_events,
    "returned_count": len(selected_events),
}
returned_count 只代表這次回傳幾筆,不是所有符合條件的會議總數。只取最早三場,就不能把「回傳三場」說成「總共只有三場」。
PAL(Program-aided Language Models,2023)採用的也是把需求理解與實際計算分開的思路:模型產生程式,再交給 Python 等執行環境計算。本文這種固定的 Calendar 查詢,則可以直接使用已測試的函式或資料庫查詢,不必每次重新產生計算程式。
不過,程式也會有 bug。資料漏查、時區或篩選規則寫錯,結果仍然可能錯;算對的數字也可能在模型轉述時被改掉。因此除了測試計算規則,重要數字也可以由程式直接填入回覆,或在輸出前核對。要減少的是不必要的誤算,不能只因為搬到 Harness 就當成萬無一失 。
確定哪些工作交給程式之後,接下來還有另一個分工問題:工具應該切多細?
Anthropic 的工具設計文章建議,從重要的工作流程出發,把經常連續出現的操作整合進工具,內部可以完成多個 API 呼叫。這不是說每個問題都要另外做一個專用工具;如果現有工具已經夠用,就先保留,拿相同任務測過再決定。
這裡有個值得拆開的直覺:既然已經有 REST API,是不是每個 endpoint 包成一個 Tool 就好了?他們也把「只包裝既有 endpoint,卻沒考慮是否適合 Agent」列為觀察到的問題。Tool 不必跟 API 一對一,應該先從希望 Agent 完成的任務與工作流程(workflow) 往回設計。
原本前端按下按鈕後,該呼叫哪些 API、怎麼組合結果,可以由工程師預先寫好;換成 Agent,這些安排就可能交給模型在執行時決定。不過,API 不是只為了畫面渲染才拆開。Microsoft 的 API 設計指南強調依業務資源設計,也提醒不要拆得太細,讓呼叫端為一件事來回請求太多次。底層 API 有它的切分理由,但不必原封不動變成模型看到的工具清單。
拿前面的 Calendar 來說,我會考慮整合固定的跨行事曆查詢、篩選與合併,必要時仍保留單場會議的明細查詢。從 workflow 出發,不代表整個 workflow 都要塞進同一個 Tool。 若下一步需要人決定是否寄邀請,就保留停下來確認的位置,不因為整合工具就把查詢和寫入綁死。
平衡點是:重複且明確的步驟交給程式,需要判斷或探索的地方,仍讓模型組合工具。Anthropic 的 Context engineering 文章也強調 工具用途要清楚,盡量減少功能重疊。我要減少的是不必要的拆解,不是把工具數量壓到最少;有沒有改善,仍要用相同任務的正確率、耗時與用量來檢查。
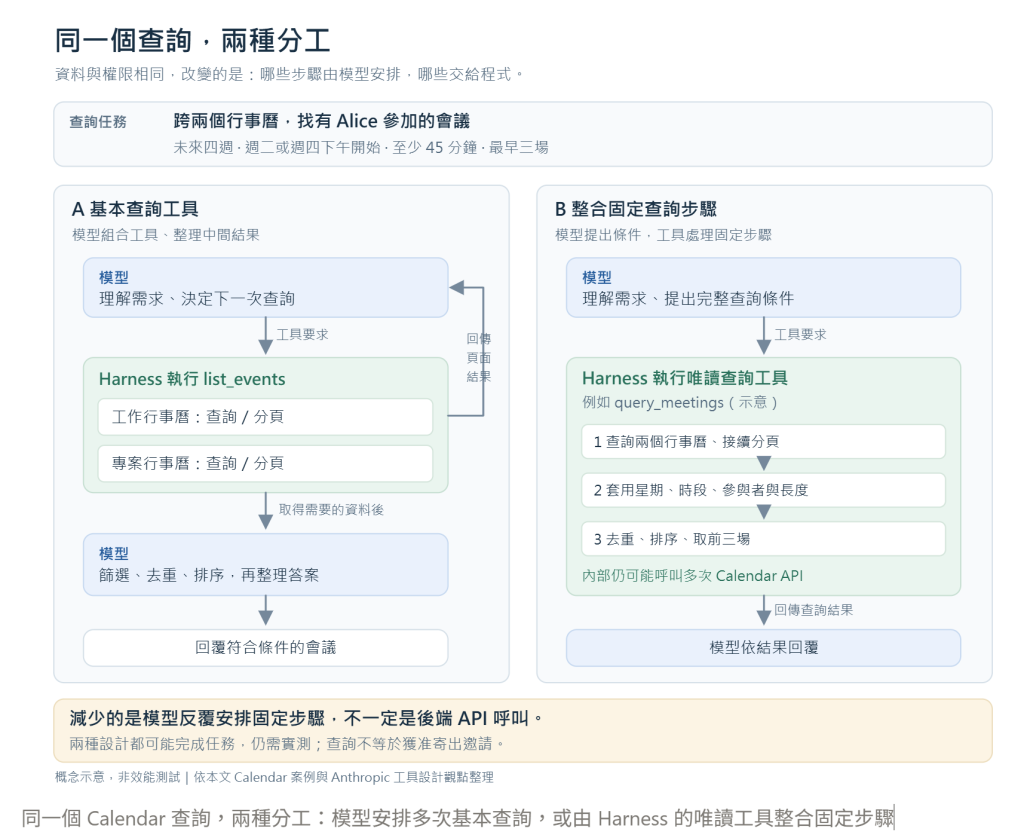
圖 1:兩種設計都可能完成查詢,差別在於分頁、篩選與合併由誰安排。工具整合不代表只呼叫一次 API,也不自動取得寫入權限。本文依上述工具設計觀點繪製,非效能比較結果。
當然,這種查詢丟給現在最強那批模型(SOTA),搞不好它都查完了,我還在解釋它為什麼可能漏條件🤡。這裡只是拿來說明分工,沒有預設模型一定會做錯。
還是同一個需求,但這次換一個條件:工作行事曆能查明細,專案行事曆卻只接了 FreeBusy,也沒有其他能確認參與者的資料來源。
Google Calendar 的 FreeBusy API回傳的是忙碌區間,不包含會議標題或參與者。例如它告訴模型「週二 14:00–15:00 忙碌」,模型知道這段時間被占用了,卻不知道是什麼會議、Amber 有沒有參加。
可以想像兩種情況:同樣是週二 14:00–15:00,一種是有 Amber 參加的專案討論,另一種是不含 Amber 的內部會議。兩種情況回傳的忙碌區間完全一樣,但一場符合查詢條件,另一場不符合。 只看這份結果,模型沒有足夠依據分辨是哪一種。
這時不是模型少想了一步。就算把時間範圍切得更細、多查幾次,只要拿回來的仍然只有忙碌區間,就補不出參與者名單。前一個例子可以靠更多查詢取得完整資料,這個例子卻是現有工具根本沒有提供那項資訊。
而且「工作行事曆已經找到三場」也不代表任務完成。假設專案行事曆裡還有一場更早、符合條件,而且沒出現在工作行事曆的會議,最後的前三場就會改變。缺少這部分明細,就不能直接把工作行事曆的結果當成兩個行事曆的完整答案。
強模型可能更早發現這個限制,回答:
工作行事曆已查到三場符合條件的會議。但專案行事曆目前只能取得忙碌時段,無法確認 Amber 是否參加,因此這三場還不能當成兩個行事曆合併後最早的三場。
這比亂答好,但更會辨認資料不足,不等於已經取得缺少的資料。 設計 Harness 時,也要把工具只能查忙閒的限制說清楚,避免把「無法判斷有沒有符合條件的會議」當成「沒有符合條件的會議」。
所以問題不一定是 FreeBusy 不好用。它能回答哪些時段忙碌,只是不足以回答這次的參與者查詢。有權限、只是沒接好明細工具,就補必要的唯讀入口;本來就不能讀,則應說明限制,讓使用者決定是否授權或調整需求,不是為了完成任務就把權限全部打開。
前一個情境是「資料查得到,但要自己組很多步驟」;這一個則是「需要的資訊沒有取得途徑」。換模型可能改善查詢的安排,卻不能代替系統提供任務需要的資訊。 最後都可能表現成找錯會議,該修改的地方卻不一樣。
回到前面的查詢,漏查第二個行事曆、拿到結果卻漏掉 45 分鐘條件,和工具根本不提供參與者,並不是同一件事。要分清楚,就得沿著昨天的 Loop 看它怎麼走到這個答案:
收到任務
→ 準備這一輪的 Context
→ 模型提出下一步
→ 檢查工具、參數、權限和資源範圍
→ 執行工具,保存並送回結果
→ 根據結果決定再跑一輪、等待,或停止
再看一個假設情境:Coding Agent 修改付款流程,先讀到舊文件,測試又因為缺套件提早退出,Tool Result 只留下最後幾行,最後把某個 passed 當成整體成功。
表面上看是「模型判斷錯」,但問題可能更早就出現在資料、工具執行或結果回傳。不能只盯著最後一句回答。
我會先問:模型這輪看到了什麼?提出什麼 Tool Call?要求有沒有被放行並執行?實際回傳了什麼?最後為什麼停止,又有什麼證據支持它說完成?
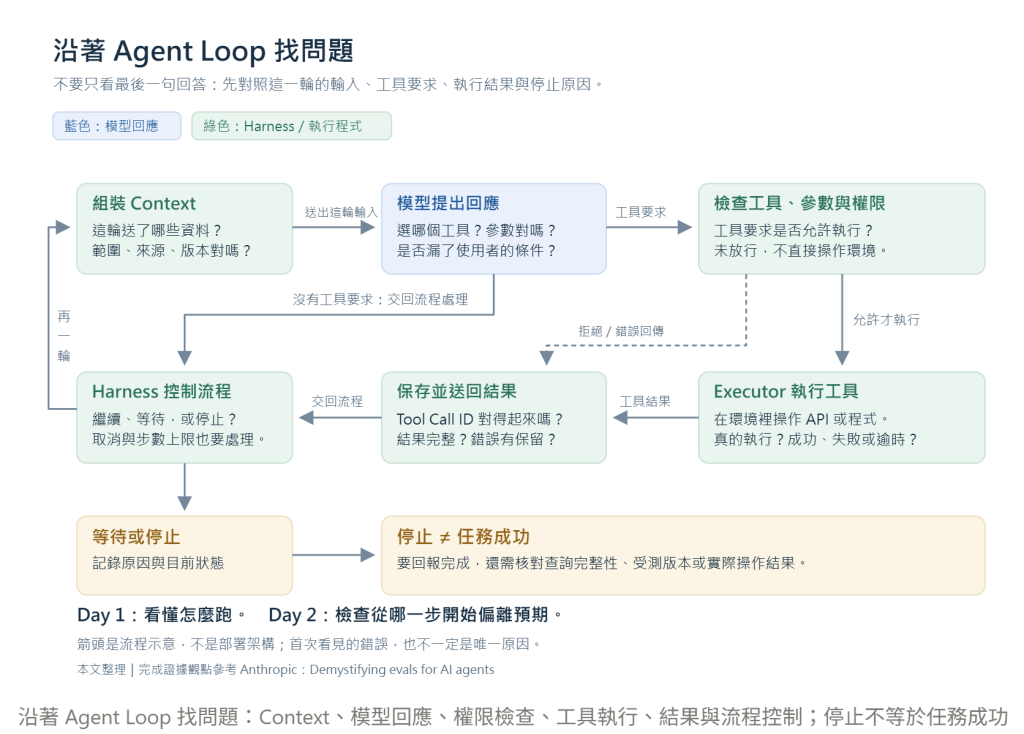
圖 2:沿著輸入、工具要求、執行與結果找證據。沒有再要求工具、收到取消或到了步數上限,都不等於任務成功。本文流程示意,非部署架構。 完成證據的區分參考 Anthropic 的 Agent 評估文章。
這些工作可以在同一支程式裡,也可以分給不同服務。先找到偏離預期的位置,才有下一步要驗證的猜測;第一個看見的錯誤,也不一定是唯一原因。
這也接回 Day 1:Tool Call 只是模型提出的要求,真正執行前,系統還有責任檢查它能不能做。 假設任務只允許查行程,就算模型提出刪除會議,也不能因此取得寫入權限。
Anthropic 的 sandbox 工程文章有個具體例子:Claude Code on the web 的 Git 操作會經過 proxy,檢查憑證與允許推送的分支,再附上正式憑證送往 GitHub。限制落在真正執行的路徑上,不只是 prompt 裡的一句「不要亂推」。
這裡先記住放行的責任就好。已有的服務權限與存取檢查可以繼續用,Harness 要把它們接進流程,不必另外重做一套權限系統。
找到可能的瓶頸後,下一步不是一次把 Prompt、Tool 和 Model 全部換掉,而是盡量控制變因。
李博傑在《深入理解 AI Agent》固定版第七章區分兩種方法:固定 Harness、只換模型,是 model swap;停用 Harness 的某個元件、觀察差異,是 ablation(消融實驗)。只替換一個工具則是對照實驗,不必一律叫消融。
套回第一個 Calendar 情境,可以固定一份測試資料、查詢日期和正確的三場會議,先只換模型;另一組則固定模型,只把篩選與合併交給工具。時間範圍、權限、資源上限和生成設定要盡量一致,不只看有沒有答對,也看耗時與用量。
評分也要符合情境:資料齊全時,應找對會議;只有忙碌區間時,應說明無法確認參與者,而不是要求它猜出三場。不能把合理回報限制算成模型失敗。
換強模型後變好,不代表問題只在模型;沒變好,也不能直接證明瓶頸在 Harness。題目可能已經太簡單,或工具不適合新模型。Anthropic 的 Agent 評估文章也提醒,同一任務要做多次嘗試,避免把一次成功當成穩定改善。這裡借用的是比較方法,沒有重現書裡的實驗。
講到這裡,好像一直在勸大家不要急著換模型。但反過來說,也不用因為現在的模型做不好,就認定這個任務不值得做。
Claude Code 的作者 Boris Cherny 在 Y Combinator 的訪談片段裡說,他們不只為今天的模型做產品,而是考慮六個月後的模 型。這是一種開發方向,不是保證六個月後什麼任務都會成功。
拿第一個 Calendar 情境來說,資料、工具都準備好了,只是模型還不能穩定完成查詢流程,那後續模型變強,確實可能讓任務成功率提高。這時可以先把 Harness 架起來,留下現在做不好的案例,不必等模型什麼都會了才開始。
Anthropic 的 Eval 文章也有類似做法:在 Agent 還做不到之前,先把預期能力寫成測試;新模型出來後再跑,看看哪些原本做不好的任務有了進展。Harness 也不是從此不動,工具和 prompt 是否要跟著調整,仍然看結果。
但第二個情境缺少參與者資料,就不能留給下一代模型猜。不要拿「等模型變強」掩蓋系統的缺口,也不要把今天模型的能力,當成產品永遠的上限。
Databricks 曾用同一個模型、相同 thinking effort 比較不同 Coding Agent Harness。在他們的任務與設定裡,有些案例品質相近,成本卻差到兩倍以上,主要差異之一就是每輪送進模型的 Context。Databricks|Benchmarking Coding Agents on Databricks' Multi-Million Line Codebase
這個例子對我最有用的地方,不是哪套 Harness 一定比較便宜,而是提醒我:看到結果差異時,除了模型名稱,也要一起看 Context、工具呼叫次數和整條執行路徑。 Harness 的影響可能出現在成功率,也可能出現在成本和步數。
Cursor 的工程文章提供另一個具體例子:他們會依模型調整編輯工具,讓其使用的 OpenAI 模型採用 patch 格式、Anthropic 模型採用字串替換,並透過離線測試與線上 A/B 比較改動。這不是所有模型永遠適用的規則,而是提醒我們:工具和模型的搭配也需要測,不能把它們完全分開看。
這也表示,API 接得通,不代表模型和 Harness 就搭得好。 從前面的案例來看,假設透過轉接把 Claude Code 背後的模型換成 GPT,就不能直接期待原本的工具格式、prompt 和提醒方式仍然同樣合適。需要重新確認的,不只是工具能不能呼叫,還有模型會不會用對、能不能根據結果繼續完成任務。
至於那個精美的 system reminder,還真的有官方故事可以對照 XD。Anthropic 的 Claude Code 工具設計回顧提到,早期每五輪會加入一次目標提醒,避免模型忘記待辦;但模型進步後,這些提醒反而可能讓它以為必須照著舊清單做,沒辦法靈活調整計畫。連 Claude 自己升級,原本有幫助的安排都可能需要重做,換到另一個模型時更值得重新檢查。
補充一下,system reminder 可以理解成 Harness 在執行過程中,適時塞給模型的提醒或狀態更新。Anthropic 的 Prompt caching 工程文章說明,Claude Code 會把更新資訊包在 裡,加入下一輪的使用者訊息或 Tool Result,而不是每次修改開頭的 system prompt,這樣也比較能保留既有快取。 所以前面要重新調整的是「提醒什麼、什麼時候提醒」,不是把整個機制拿掉;早期每五輪提醒待辦,只是其中一種用法。
不過,這不能直接推成「換成 GPT 一定比原生差」,也不能只看提醒文字就判定哪個搭配比較好。要測的是模型與 Harness 的組合,不是只看模型名稱。 可以先用相同任務比較換模型前後的結果,再針對問題調整工具或 prompt,確認哪些改動真的有幫助;原本的權限與驗證要求仍要保留。
要沿著 Loop 找問題,至少得把同一次任務的資料對起來。我會先沿用現有的 log 或資料庫,缺什麼再補,不急著做一套 tracing 平台:
| 要留下什麼 | 出問題時用來確認什麼 |
|---|---|
| 這輪輸入與資料來源 | 模型實際拿到哪段資料、哪個版本,而不只是系統存了哪些檔案。 |
| Tool Call 與對應 ID | 工具名稱、實際參數,以及回來的結果是不是這次呼叫的。 |
| 執行狀態與結果 | 要求是否被放行,工具成功、失敗、取消或逾時,完整輸出在哪裡。 |
| 停止原因與驗證結果 | 是任務完成、等待補資料,還是到了步數上限;哪些檢查真的做過。 |
這不是要求把所有內容永久存下來。我會先遮罩憑證與敏感資料,再決定哪些紀錄需要保存、誰能存取;只存一段模型摘要,則可能無法還原當時的工具結果。
Anthropic 的評估文章把執行紀錄和最終結果分開:訂票 Agent 說「訂好了」,不等於資料庫裡真的有訂位。回到我們的例子,Calendar 要確認查詢範圍與資料是否完整;Coding Agent 要有對應受測程式版本的測試結果。留下「它說了什麼」,和證明「它做成了什麼」,是兩件事。
回到前面的 Calendar 查詢,可以試著問自己:資料都有,卻漏掉「至少 45 分鐘」,和只拿到忙碌區間、沒有參與者資料,換模型能改善的事情一樣嗎?
前者可以比較換模型與調整工具的效果;後者則要先確認有沒有取得必要明細的途徑。強模型更會回報限制,是一種改善,但不等於已經完成原本的查詢。
所以今天不是要替 Model 和 Harness 選邊站,而是先沿著 Loop 找到問題,再用相同任務確認改動有沒有幫助。 現在還做不好的任務,也可以先留下測試,之後看看新模型能不能做得更好。
昨天用 Loop 看 Agent 怎麼跑,今天用它找問題。不過,知道「測試沒有跑起來」,還不等於環境已經準備好。明天就把 Environment 單獨拆開:文件從哪裡找、程式怎麼啟動,改完又拿什麼來驗證。
<system-reminder> 傳遞,而不是頻繁修改固定的 system prompt 前綴。

 iThome鐵人賽
 看影片追技術